2026年11月9日、AnthropicからFable5.2という最新モデルがリリースされた。
Proプランユーザーでも11月16日までは触れるとのこと。
前モデルのFable5.1は、Opus5.5の登場で記憶の彼方に葬り去られてしまった。果たしてFable5.2はどうなのか。
個人的な結論は「非エンジニアが飛びつく必要はない」。
そう思った理由などを解説していこうと思う。
Claudeユーザーや、Anthropicの新しいモデルに興味がある人の参考になれば幸い。
Anthropic公式の発表をざっくりと解説
2026年11月9日、AnthropicはFable5.2とMythos5.2の2つのモデルを発表した。
性能について、Anthropicは「評価したほぼすべての能力でOpus5.5より一段上」と説明している。テスターからは、Fable5.1より出力が最大30%速くなったという声も紹介されている。
ただ、同じ発表の中で、「ほとんどのコーディングや知識作業はまずOpus5.5から始めて、FableやMythosは特に難しく答えが決まっていない仕事に使ってほしい」とも書いている。
つまり、公式自身が「普段使いはOpusでいいよ」と言っているわけだ。
そもそもなんだけど、この2つのモデルの価値は「複雑な問題を、複数の工程に分けて自律的に解決できること」にある。主な舞台は、セキュリティや数学・プログラミングの領域だ。
つまり、僕を含めた非エンジニアには、このモデルの価値がすごく感じにくい。
なので、細かい数字はいったん気にせず、次の3つだけ押さえておけばOK。
- 基本的なタスクはOpus5.5を継続でOK
- 意思決定力・クリエイティブ制作には魅力
- 料金はFable5.1より安くなったけど、Opus5.5と比べると高い
ここからは、それぞれもう少し詳しく見ていく。
スペックを解説
公式ベンチマークを比較してみる
まずはAnthropicが発表した性能比較。Fable5.1、Fable5.2、Opus5.5を並べるとこんな感じ。
| 評価項目 | Fable5.1 | Fable5.2 | Opus5.5 |
|---|---|---|---|
| 業務自動化(AutomationBench) | 31.4% | 51.4% | 42.5% |
| 大規模な情報収集(WANDR) | 68.7% | 82.1% | 72.3% |
| 実務タスク(Remote Labor Index) | 17.9% | 41.3% | 21.3% |
| 図表の理解(Chartography) | 44.8% | 73.4% | 64.4% |
| ソフトウェア開発(FrontierSWE v2) | 56.3% | 69.9% | 62.3% |
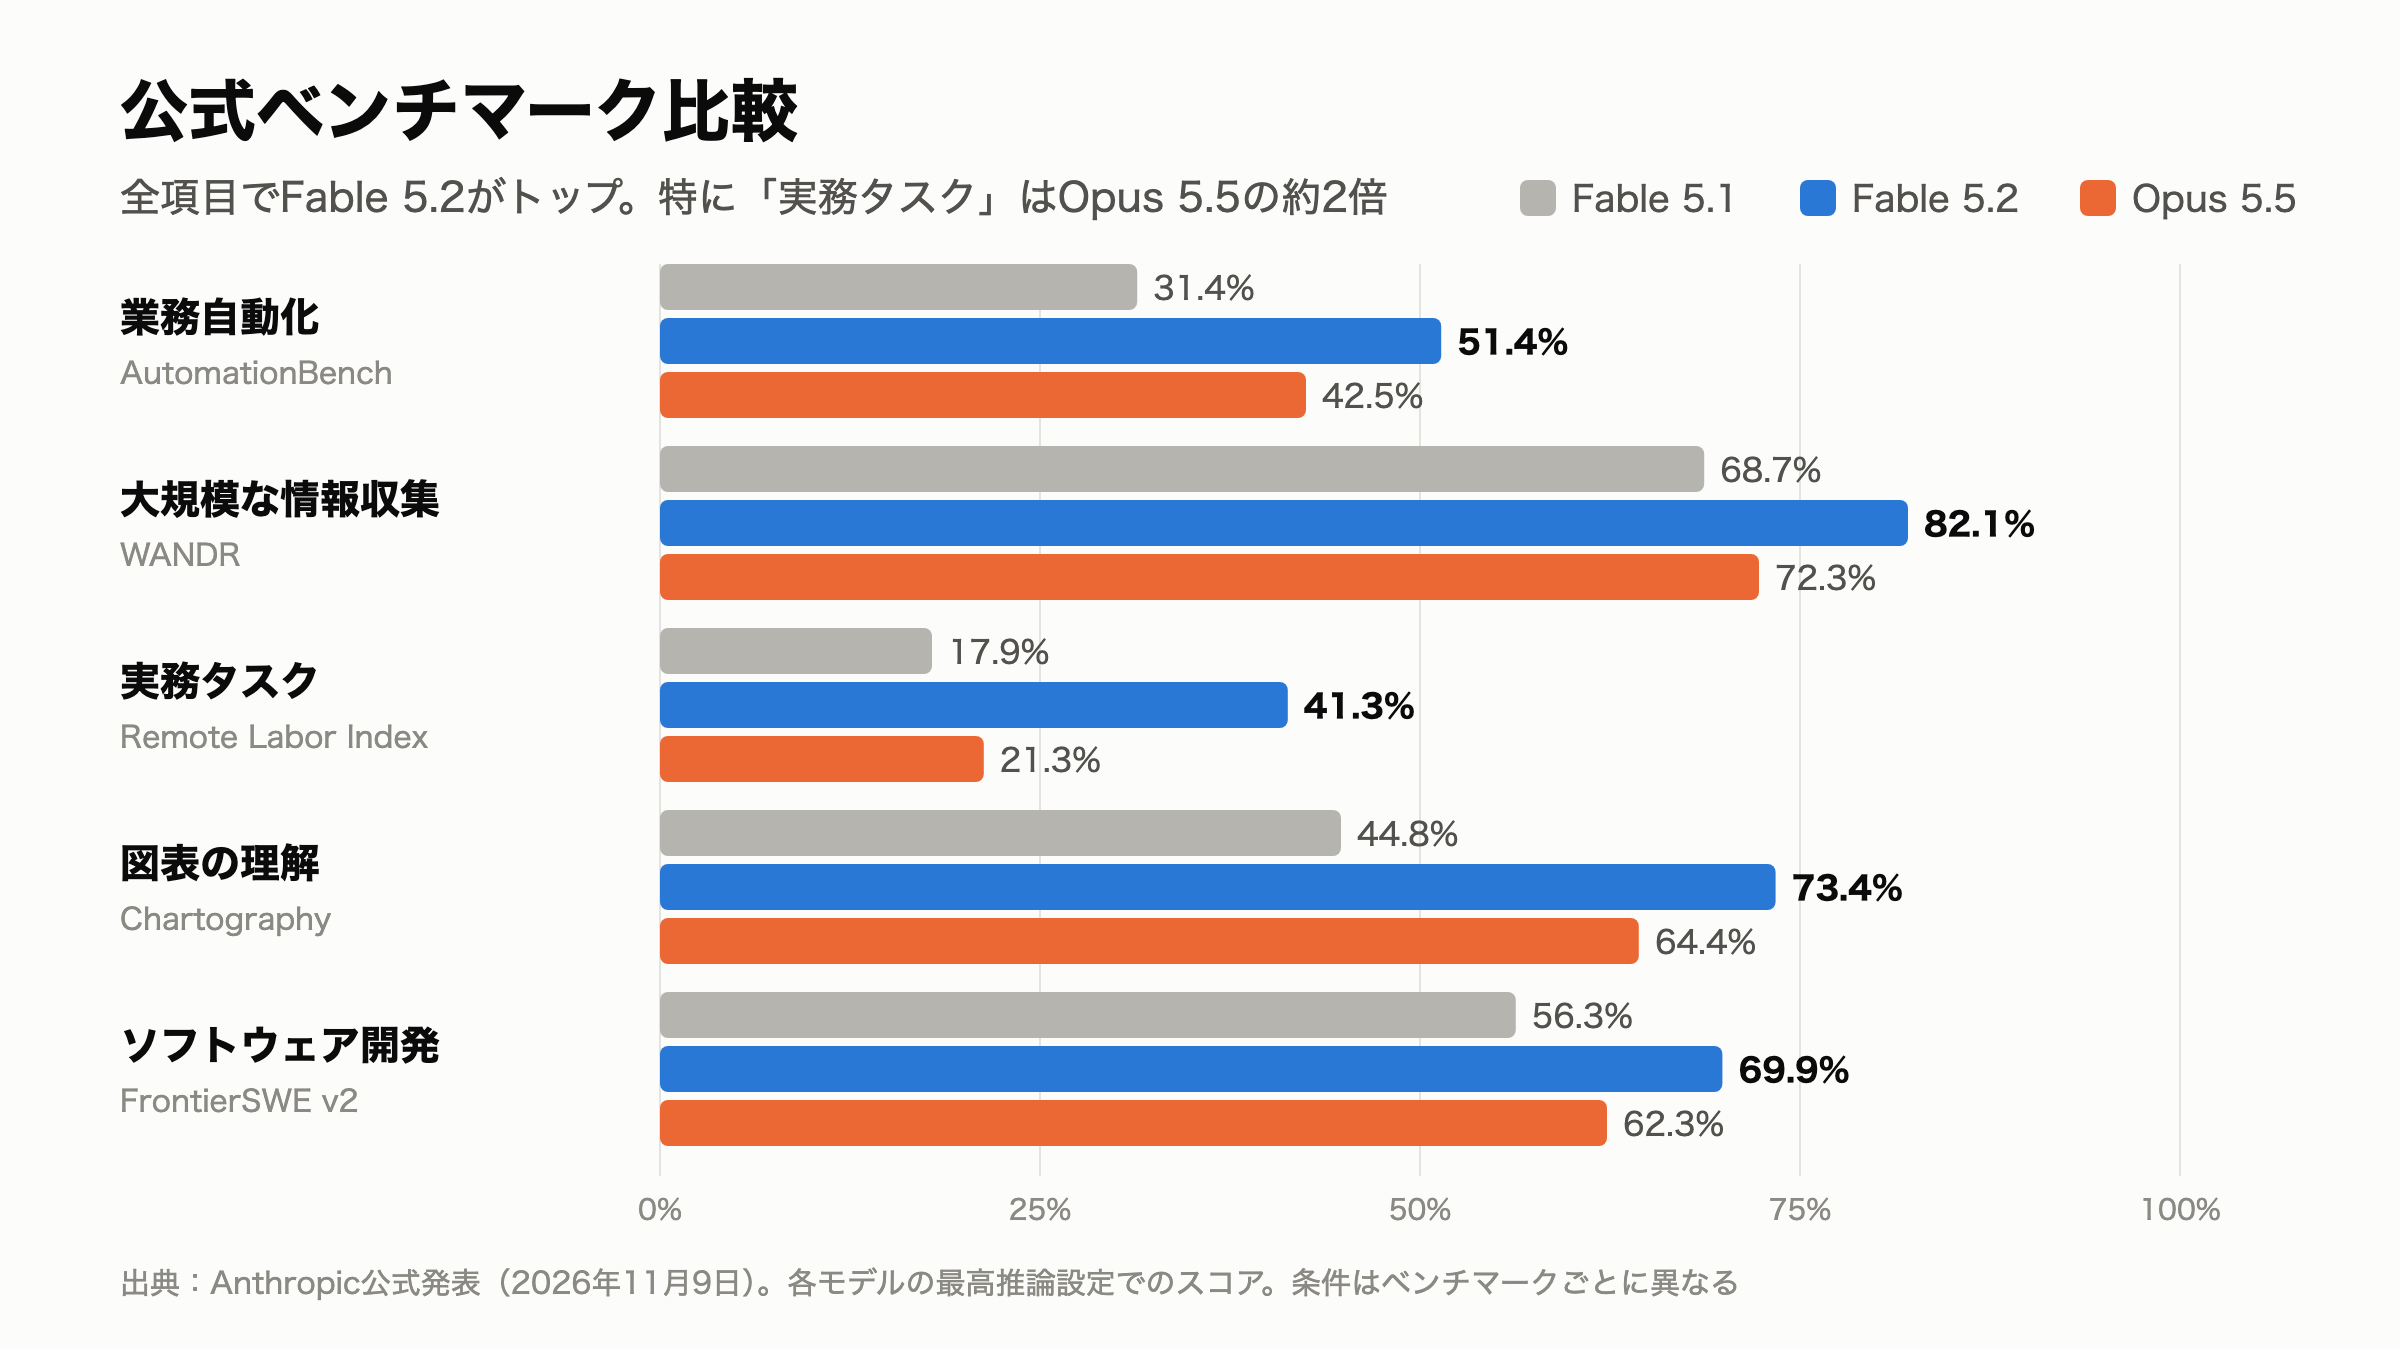
こう見ると、Fable5.2はちゃんとすごい。特に、実際の仕事に近いタスクを評価するRemote Labor Indexでは、Opus5.5の21.3%に対してFable5.2は41.3%。複数の手順が必要な仕事を進める能力が伸びていることがわかる。
ただし、これらはベンチマークごとに決められた条件でのスコアで、基本的には各モデルの最高推論設定で比較している。実際の仕事で「2倍仕事ができる」という意味ではないし、使うトークン数や料金をそろえた比較でもない。
さらに、知識労働を評価するAA-BriefcaseのEloスコアでは、Fable5.2が1785、Opus5.5が1800と、Opusが上回る指標もある。
なので、数字上は明らかに進化しているものの、普段の調べもの、文章作成、単発の制作であればOpus5.5を使い続けても十分、というのが僕の考え。
トークン料金は安くなったのか?
続いてAPIの料金。これは100万トークン当たりの金額で、Claudeの月額プラン料金とは別の話。
| モデル | 入力100万トークン | 出力100万トークン |
|---|---|---|
| Fable5.1 | $10 | $50 |
| Fable5.2 | $8 | $40 |
| Opus5.5 | $4 | $20 |
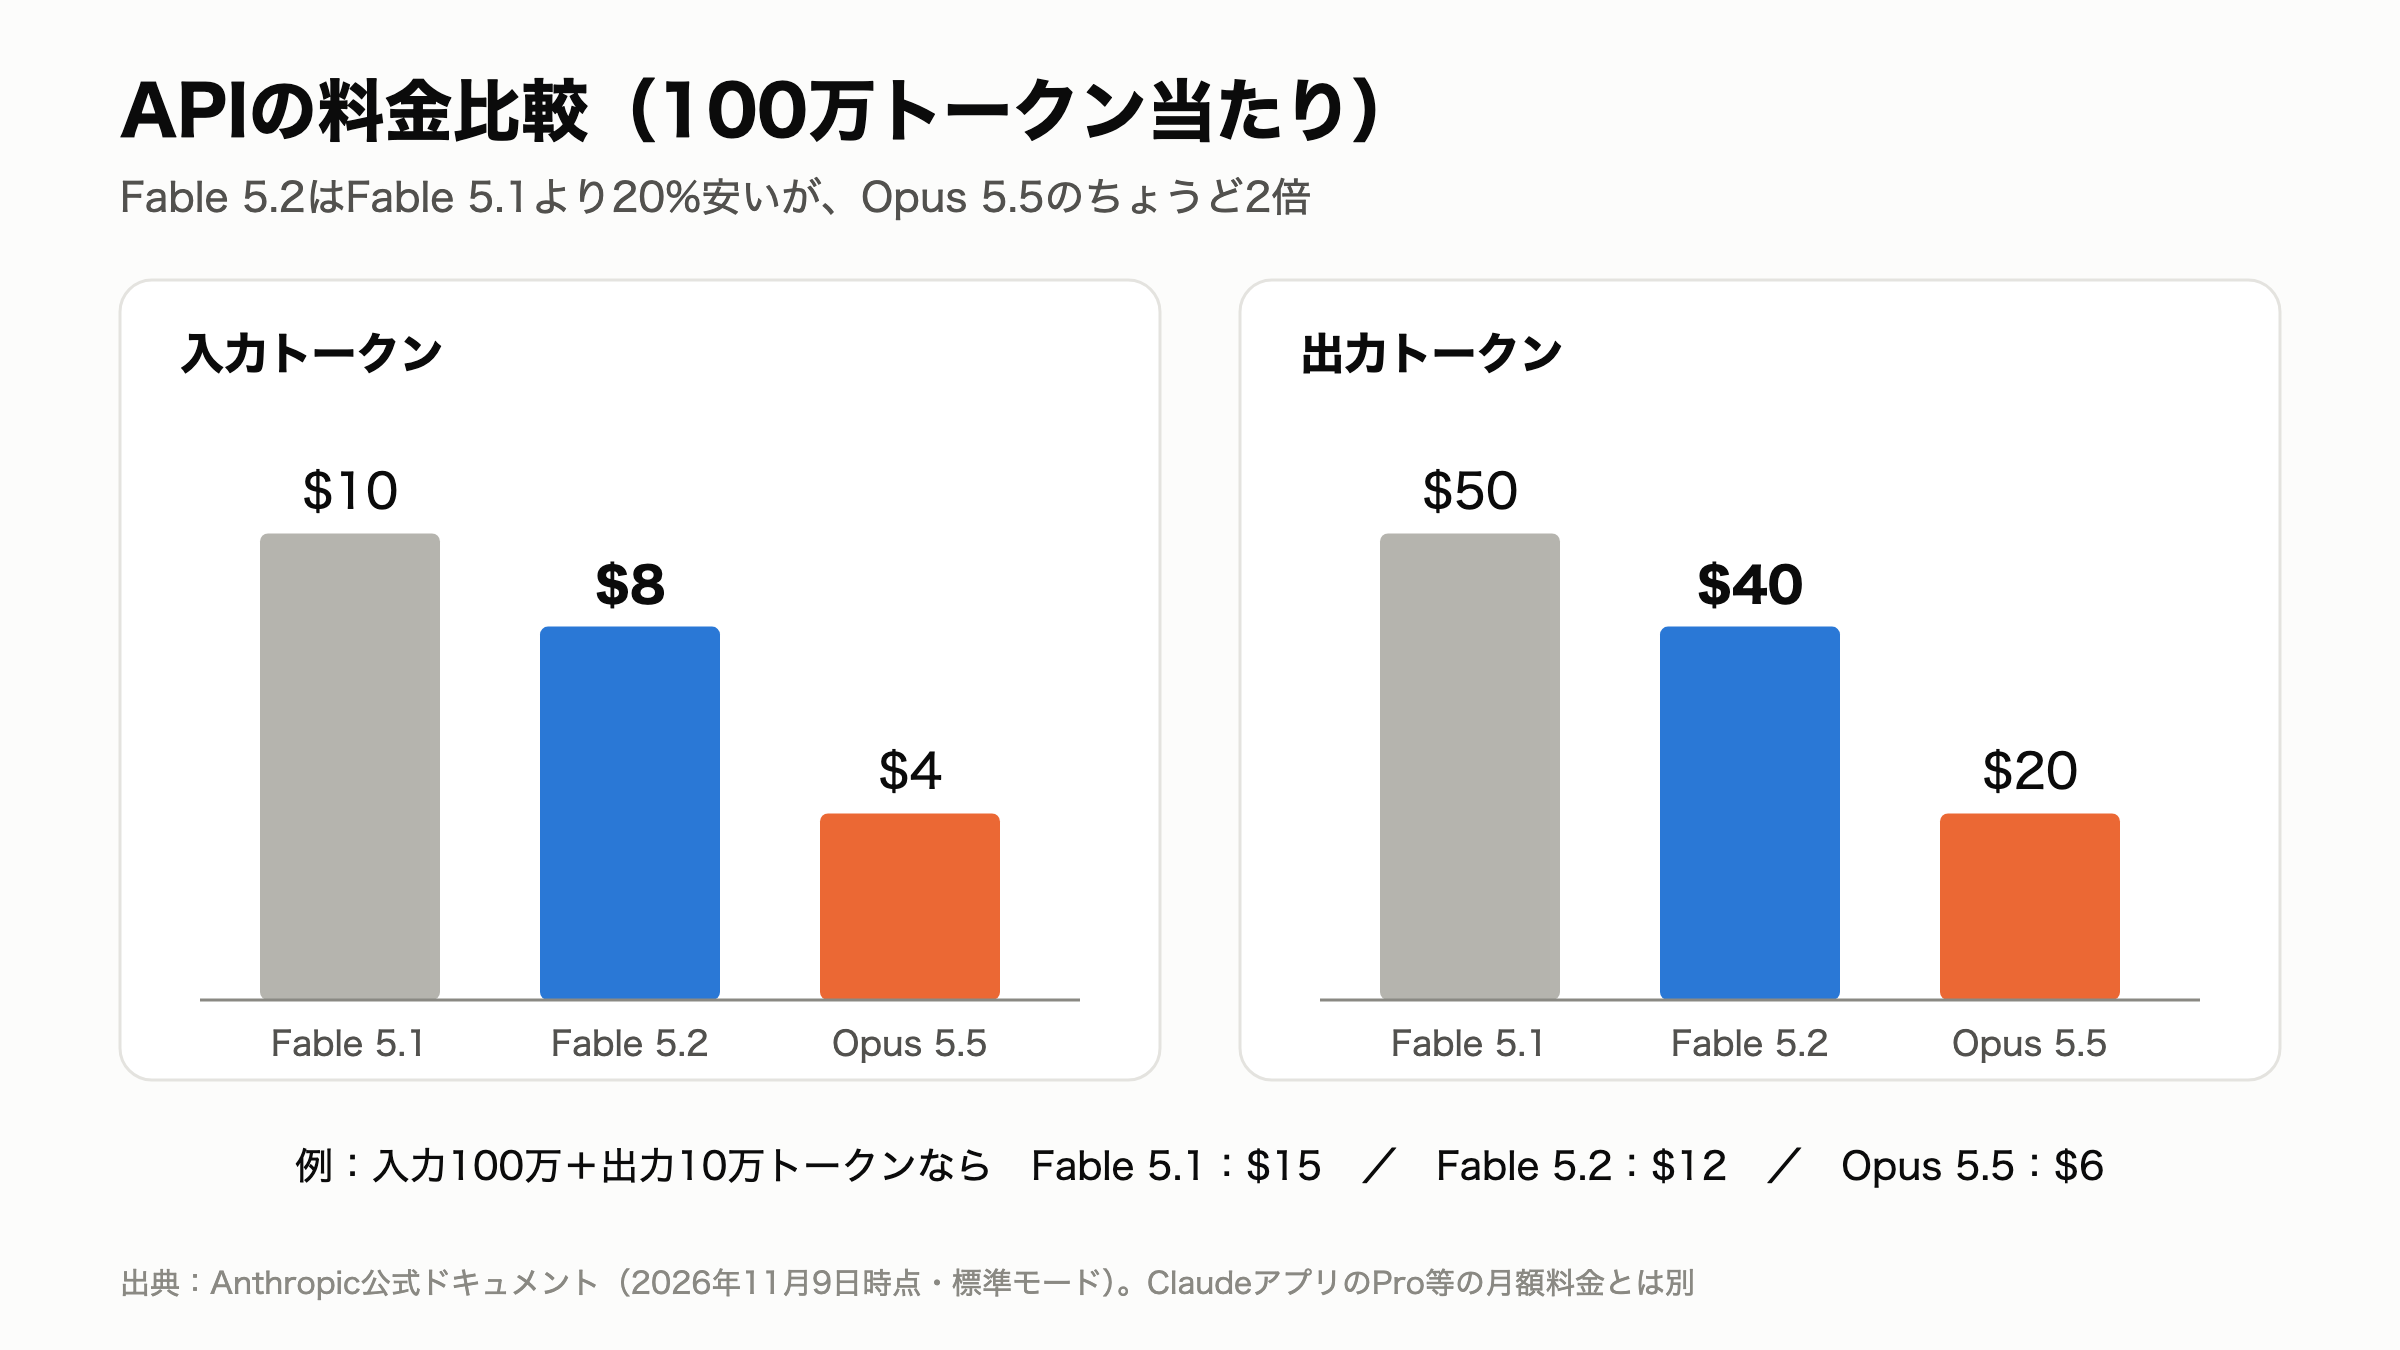
Fable5.2はFable5.1より入出力ともに20%安くなっている。でも、Opus5.5と比べるとちょうど2倍。
例えば「入力100万トークン+出力10万トークン」を使ったと仮定すると、Fable5.1は$15、Fable5.2は$12、Opus5.5は$6。もちろん実際の費用はタスクによって変わるし、高難度の仕事ではFableが少ないトークンで終わる可能性もある。
とはいえ、普段の用途で体感差が小さいなら、わざわざ高いモデルを選ぶ理由は薄いよね。
活用事例をざっくり紹介
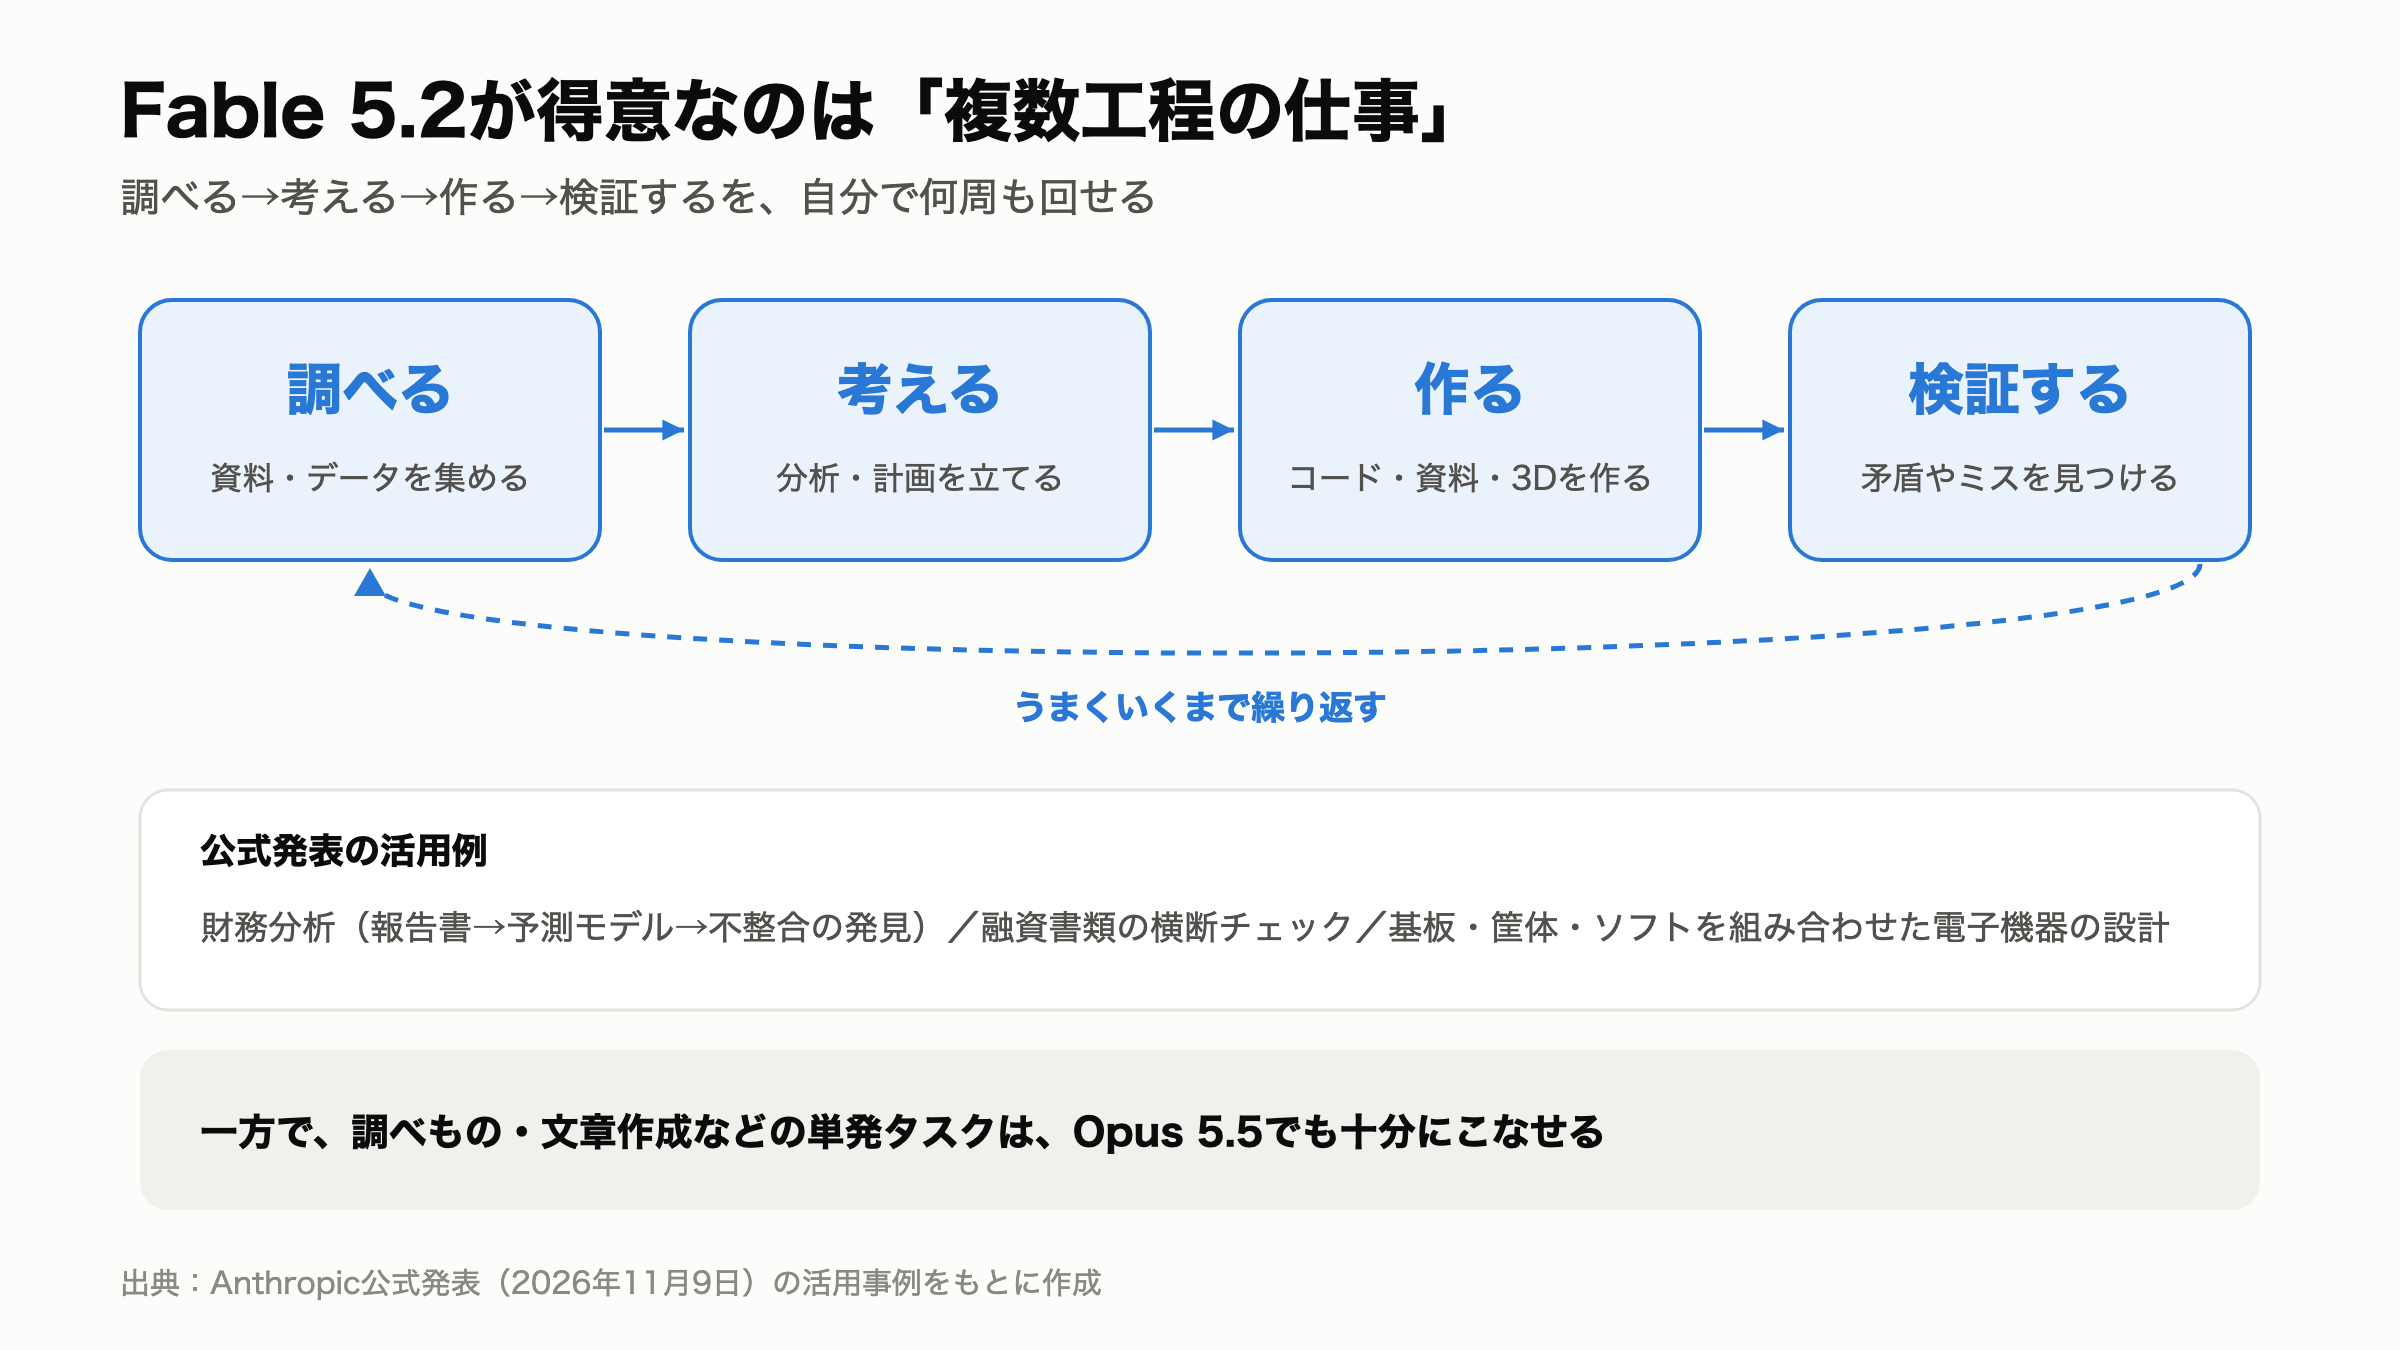
ではFable5.2はどんな仕事で活躍するのか。Anthropicの公式発表に出てきた事例を挙げると、
- 財務分析: 企業の年次報告書から数値を取り出して予測モデルに入力し、数字の不整合まで発見。
- 資料の横断チェック: 融資申請に関する複数の書類を照合し、担当者が確認すべき矛盾を指摘。
- 3D・ものづくり: 回路基板、3Dプリント用の筐体、ソフトウェアを組み合わせた電子機器を設計。Unityの担当者も、3Dシーンの構築能力を評価している。
こうした「調べる→考える→作る→検証する」という複数工程の仕事こそ、Fable5.2の得意分野なんだと思う。デザインや動画でも、コードを書いて3Dやアニメーションを作り、何度も修正していくような使い方には期待できる。
ただ、紹介されているのは公式の実験や協力企業の評価なので、誰でも同じ成果を出せるとは限らない。
参考:Anthropic公式発表(ベンチマーク・活用事例) / Fable5.2公式ドキュメント(仕様・料金) / Opus5.5公式ドキュメント
Mythos5.2とは?
Mythos5.2は、OpusやFableとは別の位置づけのモデル。基盤モデルはFableと同じだけど、Fableでは制限されている一部のサイバーセキュリティ・生物学的タスクを、認証済みの組織だけが実行できるようになっている。
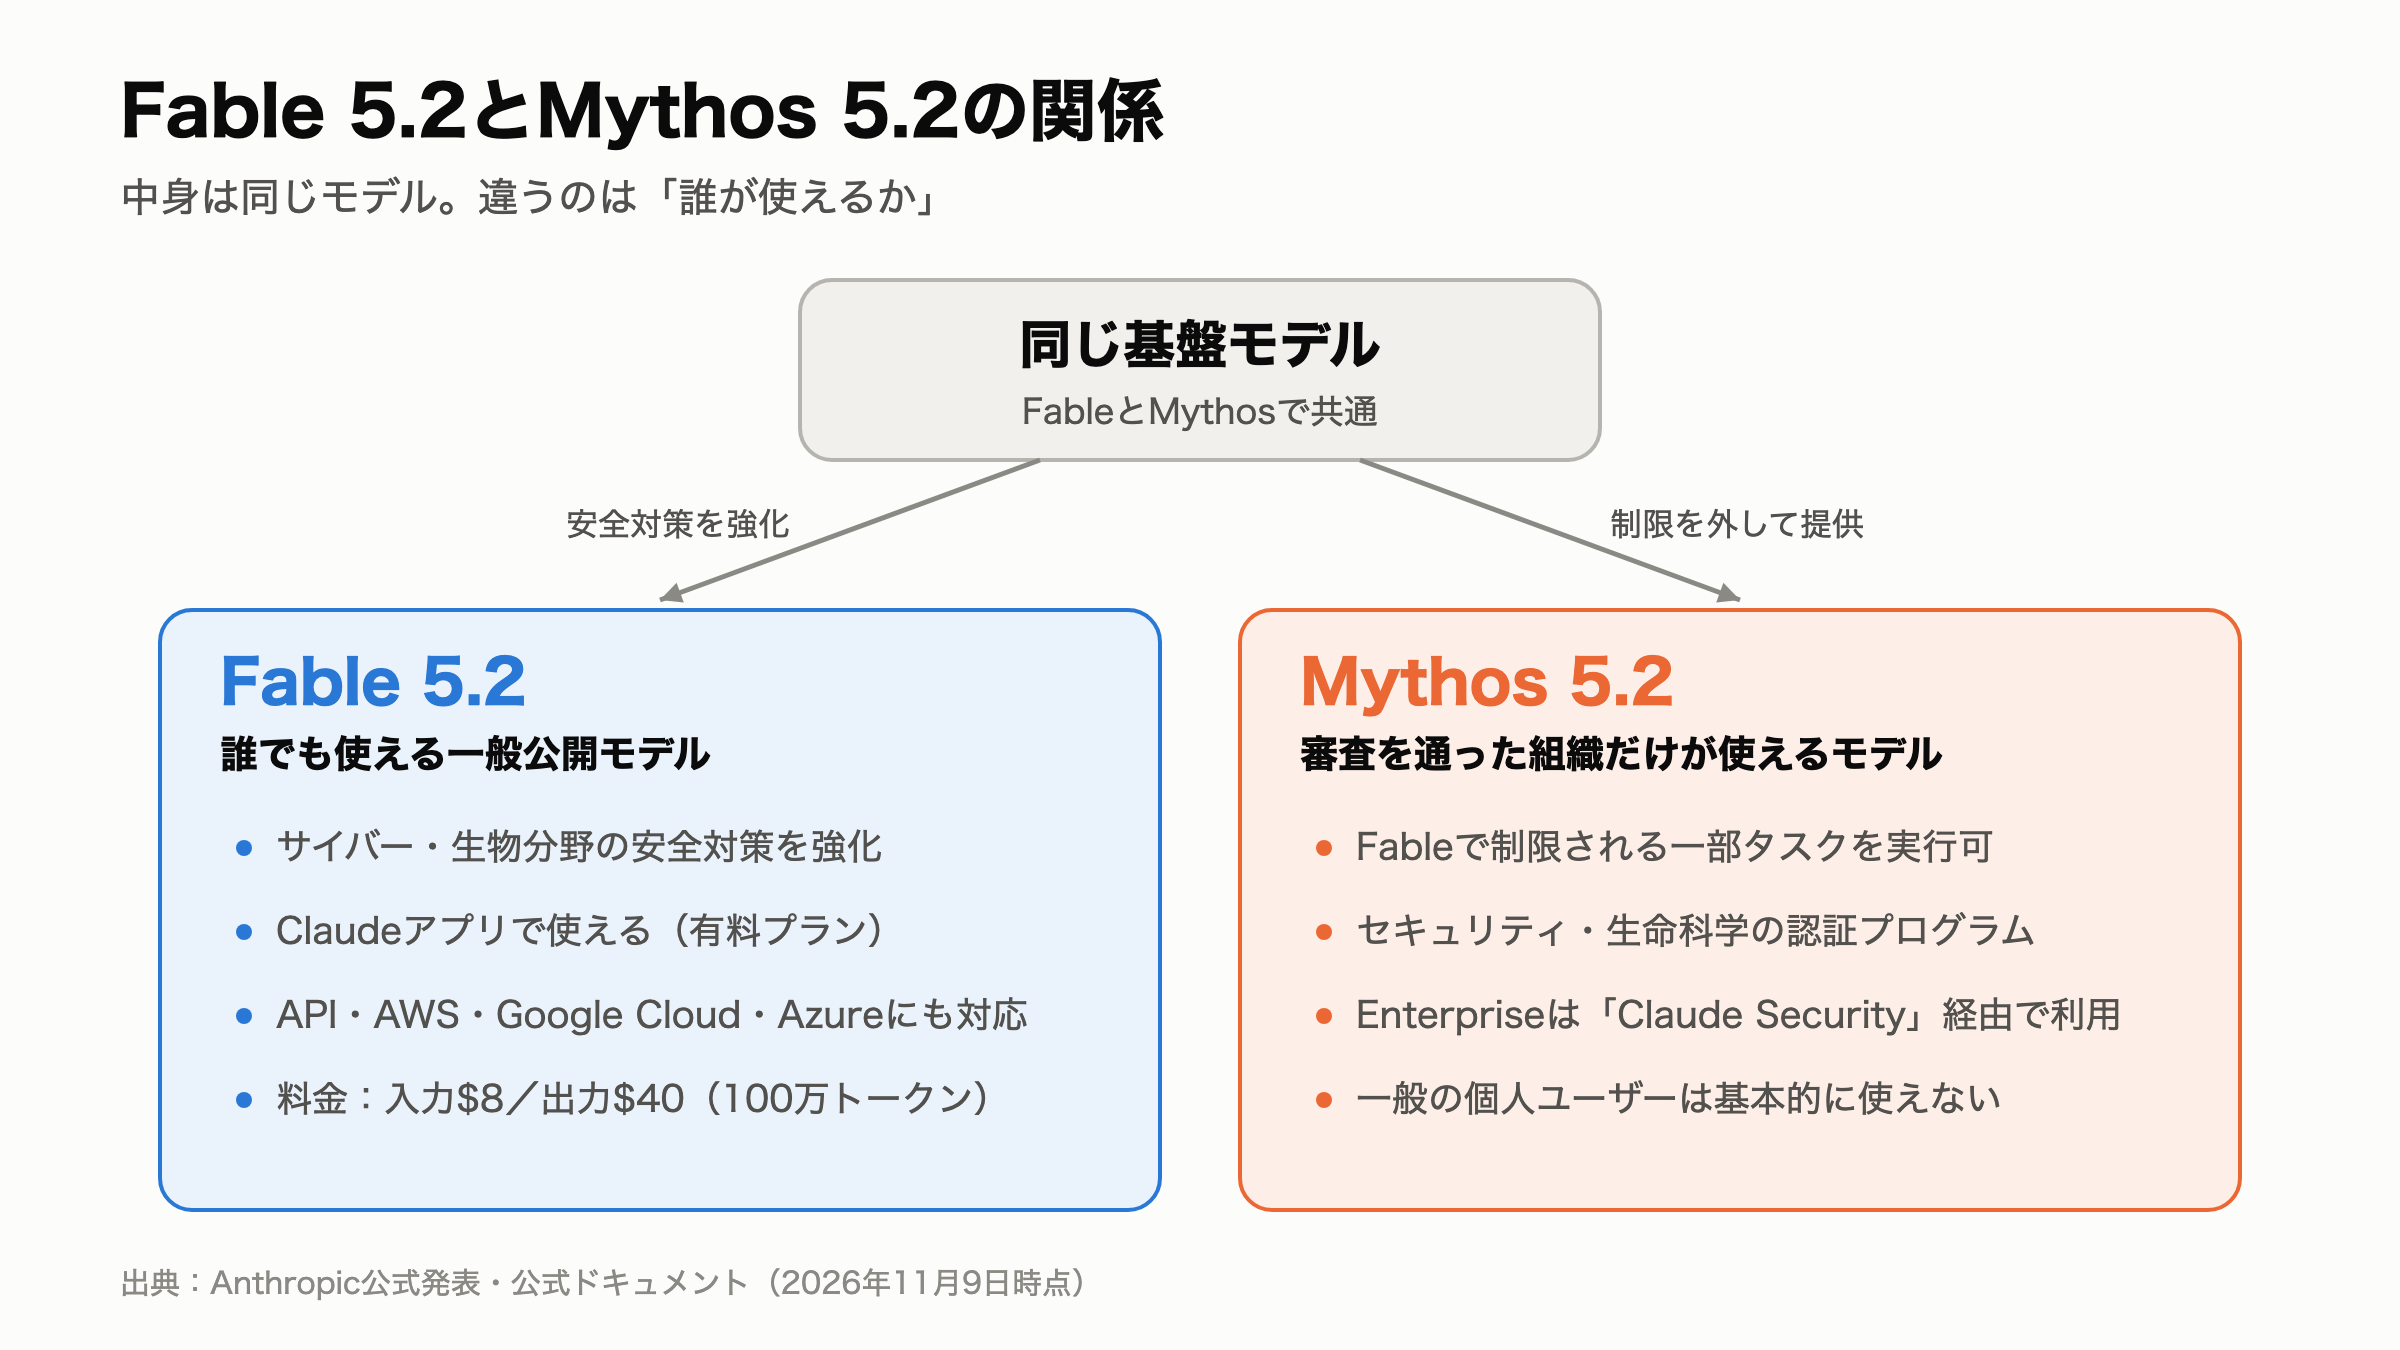
一般ピープルに使わせると危ないから、限られた組織の中で、高い倫理観と監視のもとで使っていきましょうねというモデル。
すなわち、一般の個人ユーザーにはあまり関係がない。
ただ、「サイバーセキュリティとかの脆弱性をめちゃくちゃ精度高く発見できるAIがあるんだな」「それが進化したんだな」くらいに思っておけばOK。
利用方法
話を戻して、この最新モデルのFable5.2はどうやって使えばいいのか。
期間限定ではあるんだけどProプランでも使える。今のうちに触っておこう。
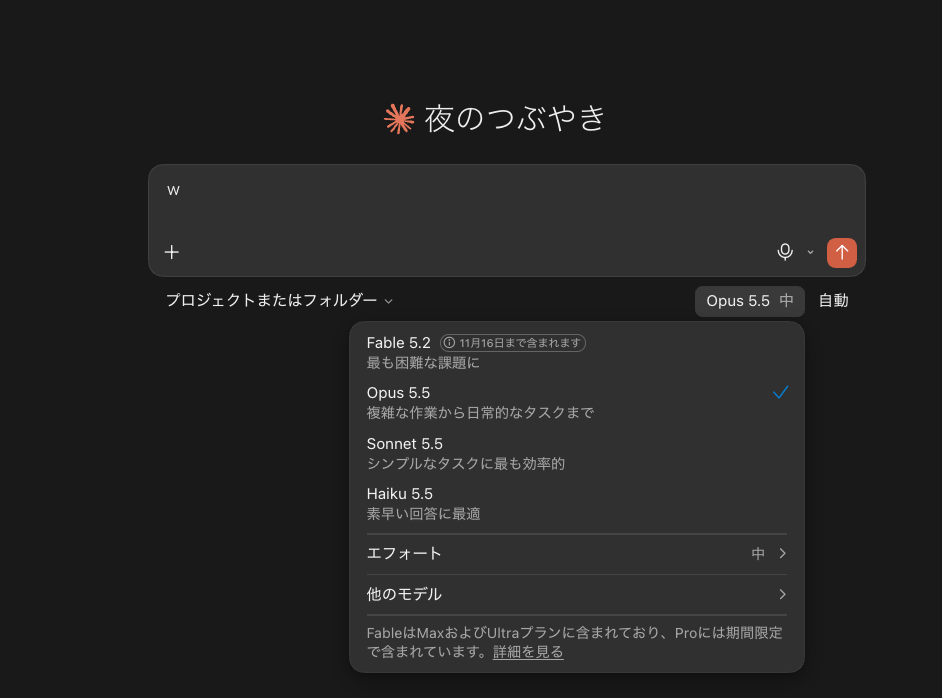
モデルの選択画面からFable5.2を選べばOK。
触ってみた感想
Opus5.5との差はあまりわからない
僕の単発タスクをいくつかやらせてみたんだけど、成果物はOpus5.5とほとんど変わらない印象。
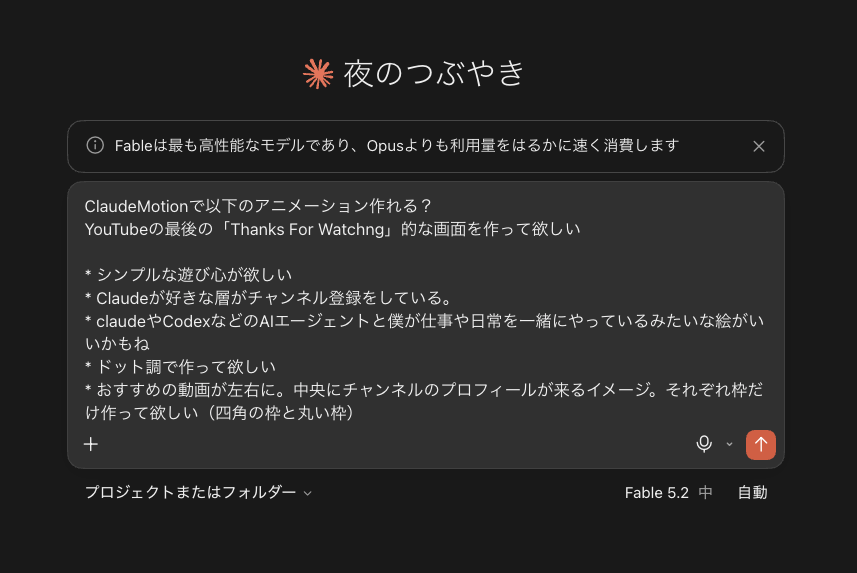
こっちがOpus5.5で作ったもの。
こっちがFable5.2で作ったもの。
注意してほしいんだけど、Fable5.2は複雑で難しい問題に対して、複数のステップを自律的に考えながら解決まで進めるモデル。
なので、普段のタスクならOpus5.5でも十分に対応できてしまうんだ。
モデルの性能差でワクワクする時代は終わってしまったのかもしれない
今回のFable5.2について、Xがすごく静か。
いつもは新しいモデルが出ると「これがすごい」「アレがすごい」とお祭り騒ぎになるんだけど、今回はみんなすっごく静観している。
多分なんだけど、一般ユーザーにもわかるほどのモデルの進化は、もうしばらく来ないのかもしれない。
とすると、次の焦点は「いかに軽く(安く)課題を解決できるか」になる。
次にワクワクするのは、Opus5.5以上の性能で、Opusより入出力の料金が安いモデルが出たときなのかなと思う。
まとめ ~何のモデルを使うかではなく、何を実現するのかに焦点が移る~
最後に、今回の内容を振り返っておく。
- Fable5.2は、複雑な問題を複数の工程に分けて自律的に解決する力が大きく伸びたモデル
- ただ、普段の調べもの・文章作成・単発の制作では、Opus5.5との差はほとんど感じなかった
- API料金はFable5.1より20%安くなったけど、Opus5.5の2倍
- Mythos5.2は認証済みの組織向けのモデルで、個人ユーザーにはあまり関係がない
- Proプランでも11月16日までは使えるので、気になる人は今のうちに触っておこう
正直、今回は「新モデルが出たから乗り換えよう」という話ではないと思う。
モデルの性能は、もう普段使いでは差がわかりにくいところまで来ている。だからこそ、これからは「どのモデルを使うか」より「AIで何を実現するか」のほうが大事になってくる。
複雑で工程の多い仕事ならFable5.2、普段使いならOpus5.5。モデル名で選ぶのではなく、自分が実現したいことから逆算して選ぶ。これからのAIとの付き合い方は、そういう形になっていくんだと思う。
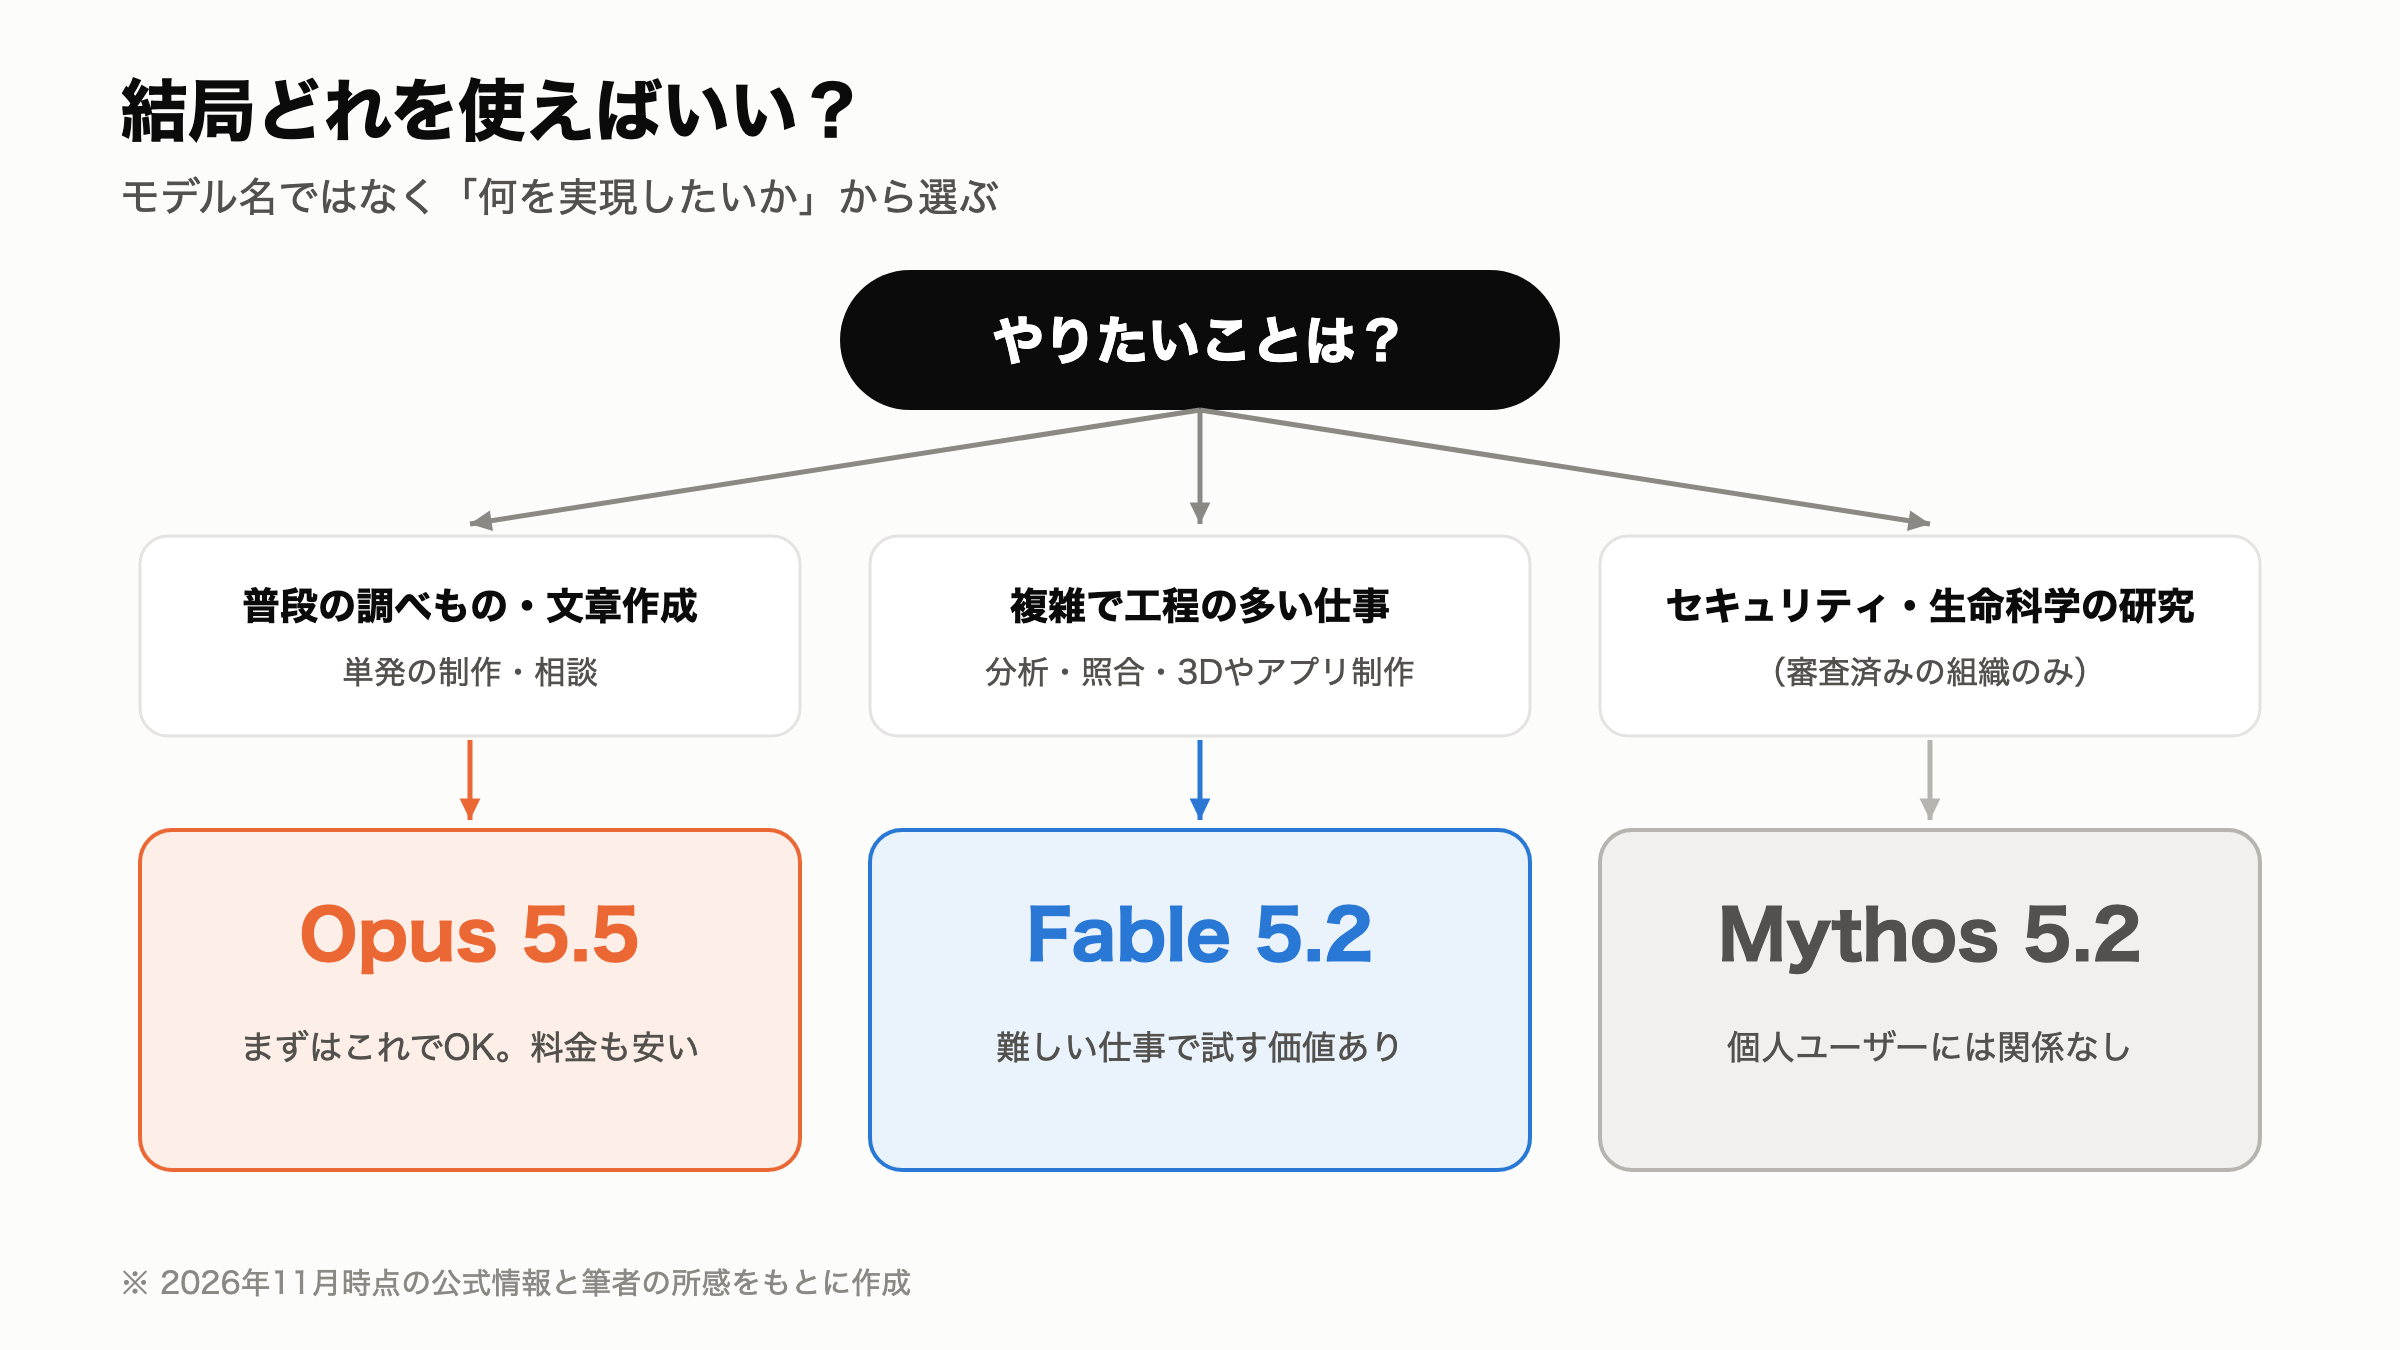
この記事が、Fable5.2を触るかどうか迷っている人のヒントになれば嬉しい。